この記事の目次 開く・閉じる
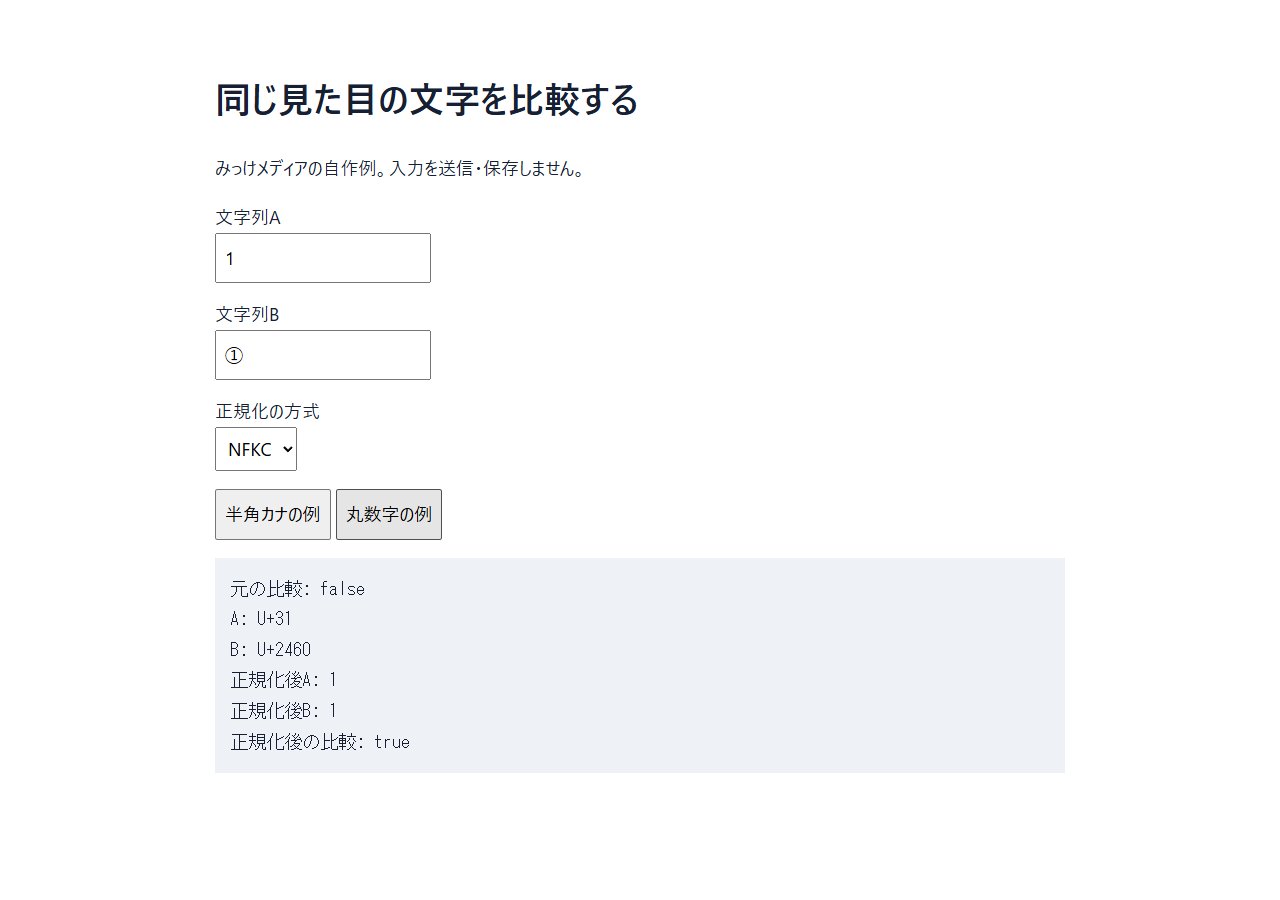
今回の仕上がり
同じ「が」に見えても、U+304Cの1文字と、U+304BにU+3099を続けた文字列はJavaScriptの厳密比較では一致しません。今回の例では元の比較がfalse、両方をNFCへ正規化した比較がtrueになりました。
正規化は、表現が異なる文字列を規則に沿って扱うための処理です。下の作例は元の入力を残し、コードポイントと正規化後の値を表示します。比較結果だけを見るより、どこが変わったか追いやすくなります。
方式を切り替える
- 最初の「が」の例で、元の比較falseと正規化後trueを確認します。
- 「半角カナの例」を押します。NFCでは「ガ」と「ガ」の比較はfalseです。
- 方式をNFKCへ変えると、両方が「ガ」になりtrueになります。
- 「丸数字の例」を押すと、NFKCでは「①」が「1」と同じになります。
必要な処理は文字列に対するnormalize呼び出しです。NFCならtext.normalize('NFC')、NFKCならtext.normalize('NFKC')を使います。今回のサンプルは比較用の値を別に作り、入力欄そのものを自動変換しません。
比較条件を決める
NFKCは半角カナなどの違いを揃えられますが、丸数字のような表現の違いも失われます。検索用の比較値を別に作るのか、保存する原文まで変えるのかを先に決めてください。名前・パスワード・識別子へ一律に適用する方針は、この実験からは決められません。
normalizeの仕様説明と今回のブラウザ実験を照合しました。2026年10月22日のUnicode公式発表も調査の入口にしていますが、normalizeが今回新しく追加されたという説明ではありません。Xの元投稿や反響は確認できておらず、流行とは断定しません。
文字数の違いを先に確認したい場合は文字の数え方を比べる記事へ進めます。今回はブラウザで3種類の例を確認し、全Unicode文字やサーバー側の検索処理までは検証していません。
操作できる作例
確認日:2026年10月29日。PCブラウザとスマホ幅で確認。スマホ実機・読み上げ・全ブラウザは未確認です。